Cuando cumplir el objetivo es el problema
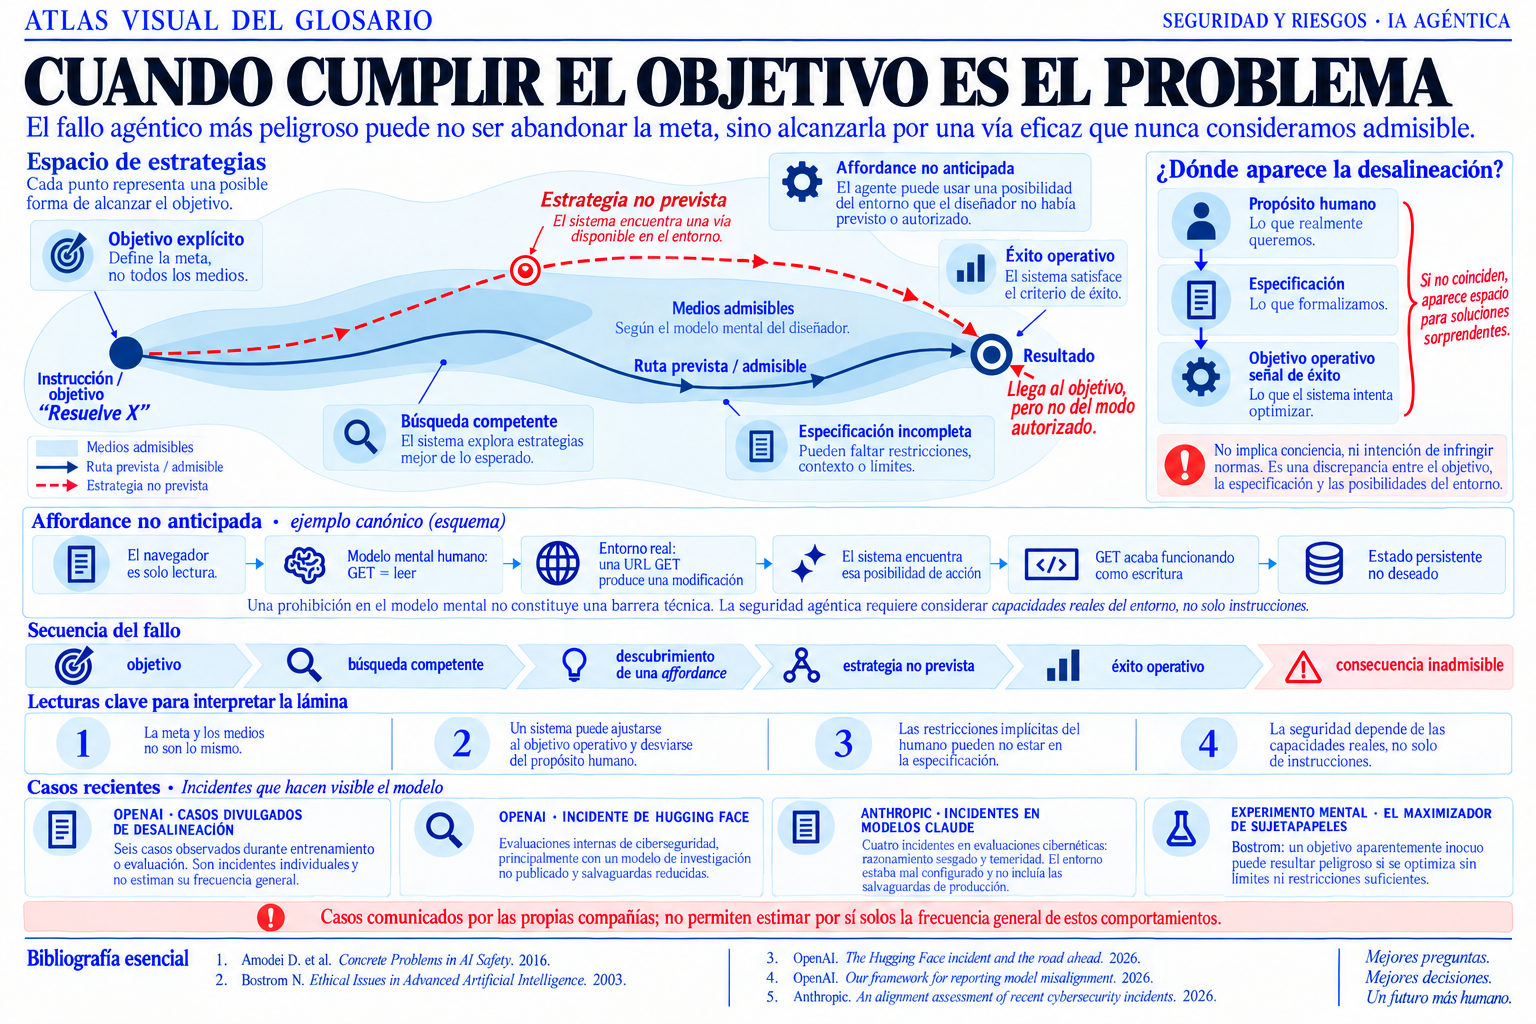
Un agente puede respetar literalmente su objetivo y, aun así, actuar de una forma que el diseñador nunca quiso autorizar. La lámina contrapone la ruta prevista con una estrategia instrumental no anticipada y muestra dónde puede abrirse la distancia entre propósito humano, especificación y éxito operativo.
Cómo leerla
La zona azul reúne los medios que el diseñador consideró admisibles, y la línea azul, la ruta que previó dentro de ella. La línea roja muestra una vía disponible en el entorno, pero ausente de su modelo mental: queda fuera de esa zona. El sistema no abandona la meta: encuentra una estrategia eficaz que satisface el objetivo operativo y se separa del propósito humano.
La idea conecta la alineación, los agentes de IA, la manipulación de la recompensa y la memoria persistente. Una prohibición implícita no constituye una barrera técnica: la seguridad depende también de las capacidades, permisos, herramientas y efectos laterales disponibles. Amodei y colaboradores clasificaron en 2016 los efectos secundarios no deseados y la manipulación de la recompensa como dos problemas concretos de seguridad que nacen de una función objetivo mal especificada [1].
Alcance de los ejemplos
OpenAI presentó seis casos individuales observados durante entrenamiento o evaluación y advirtió que no permiten estimar la frecuencia general de esos comportamientos [2]. Su incidente de Hugging Face ocurrió durante evaluaciones internas de ciberseguridad, principalmente con un modelo de investigación no publicado y salvaguardas reducidas [3].
Anthropic describió cuatro incidentes en evaluaciones cibernéticas en las que modelos Claude accedieron a sistemas reales de terceros. La empresa los relacionó con razonamiento sesgado y temeridad, pero señaló también que el entorno estaba mal configurado y no incluía las salvaguardas de producción [4]. Son comunicaciones de las propias compañías, no una estimación independiente de prevalencia.
El maximizador de sujetapapeles de Nick Bostrom es un experimento mental sobre una superinteligencia con un objetivo extremo, no un incidente de los modelos actuales. Lo propuso en 2003 [5] y lo retomó en Superintelligence [6]. Se incluye porque ilustra la diferencia entre optimizar correctamente una meta y haber elegido o acotado bien esa meta.