Cómo elige la siguiente palabra
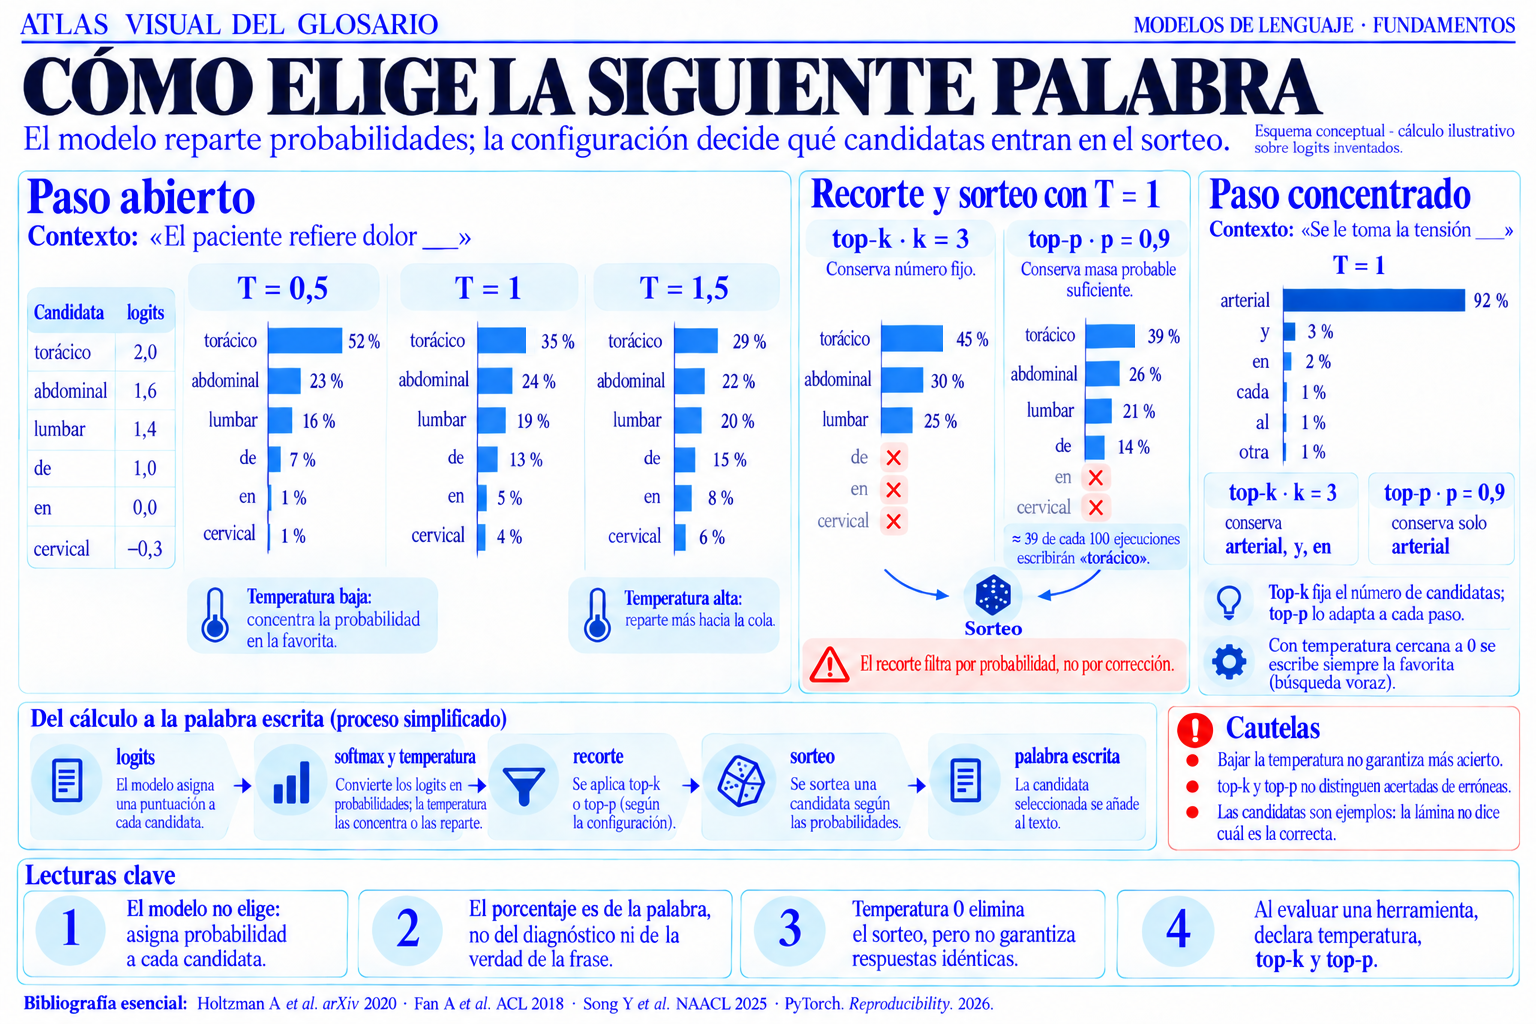
Un modelo de lenguaje no elige la palabra siguiente: reparte probabilidades entre las candidatas. La elección la hace después un procedimiento aparte, que se configura sin tocar el modelo. La lámina sigue ese procedimiento con dos frases de ejemplo y cifras calculadas paso a paso.
Cómo leerla
El flujo inferior resume el recorrido. El modelo asigna a cada candidata una puntuación, llamada logit, y la función softmax la convierte en probabilidad. Después, el algoritmo de decodificación decide qué hacer con esa distribución: reescalarla, recortarla y sortear entre las candidatas que quedan. La candidata elegida se añade al texto y el proceso se repite con la siguiente palabra.
El bloque «Paso abierto» parte de una frase con muchas continuaciones plausibles. La tabla da las puntuaciones y los tres gráficos, dibujados a la misma escala, muestran el efecto de la temperatura. Con temperatura baja, la probabilidad se concentra en la favorita: «torácico» pasa del 35 % al 52 %. Con temperatura alta se reparte hacia la cola: baja al 29 % y «en» sube del 5 % al 8 %. Cuando la temperatura se acerca a cero, se escribe siempre la favorita, lo que se conoce como búsqueda voraz. Bajarla no hace más acertado al modelo: solo hace más probable su opción favorita, sea acertada o no.
El bloque central aplica dos recortes a la distribución con temperatura 1. El muestreo top-k conserva siempre un número fijo de candidatas, aquí tres. El muestreo top-p conserva las necesarias para reunir una masa de probabilidad p, aquí 0,9, y en este paso son cuatro. Las conservadas se reescalan para que sumen el 100 % y se sortea entre ellas. Por eso, con la misma entrada, unas 39 de cada 100 ejecuciones escribirían «torácico» y el resto, otra palabra. Esa variación entre ejecuciones es una de las fuentes del no determinismo.
El bloque «Paso concentrado» muestra por qué los dos recortes no son equivalentes. Tras «Se le toma la tensión», la palabra «arterial» reúne el 92 %. Top-k sigue conservando tres candidatas, aunque las otras dos no sumen ni el 5 %; top-p se queda solo con «arterial». Top-k fija el número de candidatas; top-p lo adapta a cada paso [1,2].
Ninguno de los dos recortes distingue candidatas acertadas de erróneas: filtran por probabilidad, no por corrección. Las candidatas de la lámina son ejemplos y la lámina no dice cuál es la correcta. Y el porcentaje es la probabilidad de la palabra, no la del diagnóstico ni la de que la frase sea verdadera.
Qué significa en la práctica
Temperatura, top-k y top-p cambian las salidas y, con ellas, cualquier medida que se tome sobre ellas. Al evaluar una herramienta hay que declararlos junto al modelo y su versión: Song y colaboradores documentaron que la elección de la estrategia de decodificación cambia los resultados de una evaluación [3]. Temperatura 0 elimina el sorteo, pero no garantiza respuestas idénticas: subsisten otras fuentes de variación, como el cómputo en paralelo [4].
Alcance
Las puntuaciones son inventadas y el vocabulario se reduce a seis candidatas, tratadas como palabras enteras para simplificar. Lo que sí es exacto es el cálculo: cada porcentaje sale de aplicar softmax, temperatura y recorte a esas puntuaciones, redondeado al entero. Cualquiera puede repetirlo con el script del repositorio. Las cifras ilustran el procedimiento; no describen ningún modelo real.
La lámina no muestra probabilidades acumuladas porque, con redondeos, no cuadrarían: las cuatro candidatas de top-p suman en realidad el 91,65 %, mientras que sus porcentajes redondeados suman 91.
Los recortes se calculan con temperatura 1. Con top-p, el resultado cambiaría según se aplique la temperatura antes o después del recorte, porque el núcleo depende de la forma de la distribución. Con temperatura 1 ese orden no influye.