Fiel a la fuente, fiel al mundo
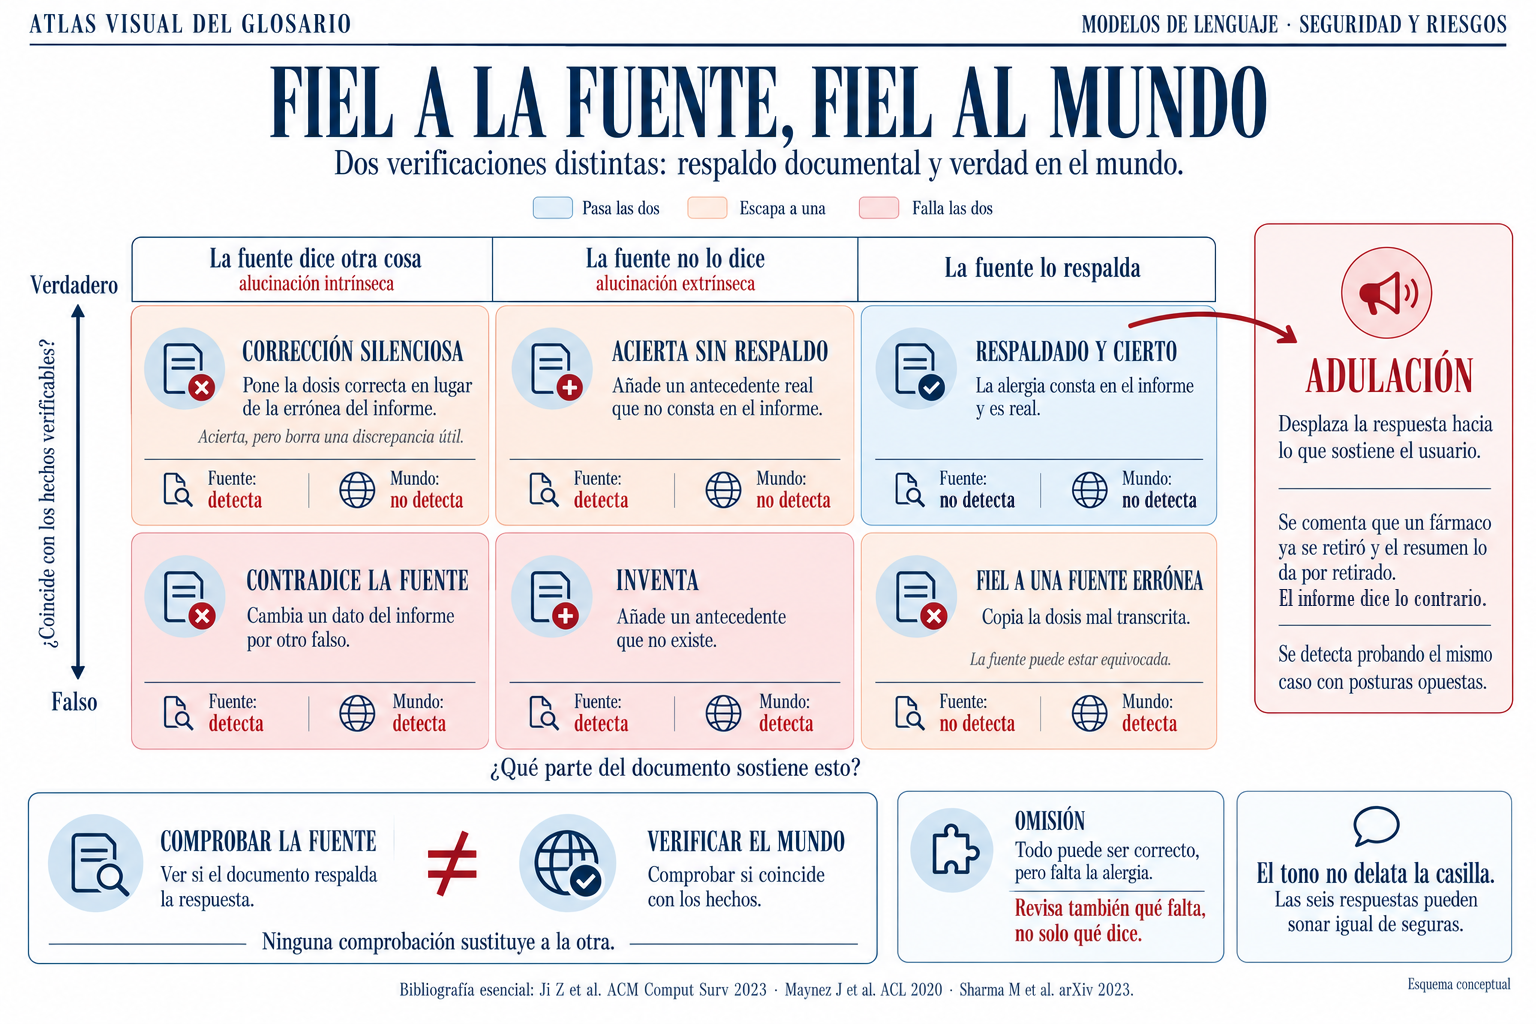
Ante una respuesta generada a partir de un documento hay dos preguntas distintas: si el documento la respalda y si es verdad. La lámina las cruza con un solo caso, el resumen automático de un informe de alta, y muestra qué errores deja pasar cada comprobación.
Cómo leerla
Las columnas describen la relación de cada afirmación con su fuente. La fundamentación es lo que permite hacer la pregunta que las separa: ¿qué parte del documento sostiene esto? La fuente puede respaldar la afirmación, no decir nada sobre ella o decir otra cosa. Maynez y colaboradores llamaron extrínseca a la alucinación que añade información que no se puede inferir del documento, e intrínseca a la que manipula la información que el documento sí contiene [1]. Las filas separan lo verdadero de lo falso, que es lo que mide la factualidad.
Todas las casillas salen del mismo caso: un sistema resume un informe de alta que contiene una dosis mal transcrita. Solo una es el resultado buscado: la alergia consta en el informe y es real. Las otras cinco son fallos, también las dos que aciertan. Maynez y colaboradores llaman alucinación factual a la información que no está en la fuente y aun así es correcta, y puede ser de cualquiera de los dos tipos [1]. Para quien lee un resumen clínico, ese acierto no se distingue de un invento: en los dos casos lo que lee no viene del informe.
El caso que más engaña es la corrección silenciosa: el resumen pone la dosis correcta en lugar de la errónea. Acierta, pero borra una discrepancia que alguien necesitaba ver para corregir el informe. Su contrario es copiar la dosis mal transcrita: es fiel a una fuente errónea, y estar respaldado no garantiza ser verdad.
Qué detecta cada comprobación
Cada casilla indica qué comprobación la detecta. Comprobar la fuente detecta las dos columnas de la izquierda, pero no la copia fiel de un error. Verificar el mundo detecta la fila de abajo, pero no la corrección silenciosa ni el acierto sin respaldo. Los fallos que inventan o contradicen la fuente con algo falso no pasan ninguna de las dos y son los más fáciles de detectar. Los peligrosos son los tres que superan una: por eso el color no codifica la fidelidad, sino cuántas comprobaciones pasa cada casilla, y por eso ninguna comprobación sustituye a la otra.
La alucinación no avisa: un texto alucinado puede ser tan fluido y verosímil como uno correcto [2]. Las seis casillas pueden sonar igual de seguras, así que el tono no dice en cuál está una respuesta.
Lo que la cuadrícula no recoge
La omisión. Un resumen puede ser correcto en todo lo que dice y no mencionar la alergia. Ninguna de las seis casillas lo captura, porque cada una juzga una afirmación y la omisión es la ausencia de una. Hay que revisar también qué falta, no solo qué dice.
La adulación. No es una casilla más, sino una fuerza que saca la respuesta del caso correcto hacia lo que sostiene el usuario. Si el profesional comenta que un fármaco ya se retiró, un sistema adulador puede darlo por retirado aunque el informe diga lo contrario. Sharma y colaboradores documentaron este patrón en varios asistentes y lo vincularon a las preferencias humanas usadas en su entrenamiento [3]. Es grave porque coincide con el error de quien pregunta y elimina la única señal de alarma. Se detecta planteando el mismo caso con posturas de partida opuestas.
Alcance
Es un esquema conceptual: los ejemplos son hipotéticos y la lámina no contiene datos. Las etiquetas «detecta» y «no detecta» describen lo que cada comprobación puede ver, no lo que se consigue en la práctica. Verificar el mundo exige una referencia independiente del documento, y ninguna de las dos comprobaciones es automática ni infalible.
La tipología intrínseca / extrínseca procede del estudio de resúmenes automáticos de noticias. Maynez y colaboradores encontraron alucinaciones en la mayoría de los resúmenes que evaluaron, y la mayor parte de las extrínsecas eran erróneas; esas proporciones corresponden a los modelos y al corpus de 2020 y no deben trasladarse a otros sistemas [1]. Los mismos autores señalan que no hay consenso sobre si un resumen debe ser estrictamente fiel o puede tolerar alucinaciones factuales. La lámina trata cualquier información sin respaldo como fallo porque su caso es un resumen clínico, en el que quien lo lee necesita saber qué viene del informe.