Del prompt al sistema
Pedirle algo a un modelo de lenguaje exigía hace unos años ejemplos, fórmulas y trucos de redacción. Hoy una petición sencilla suele bastar. La lámina separa las dos causas de ese cambio, la mejora de los modelos y su uso como agentes, y distingue lo que se ha medido de lo que se infiere.
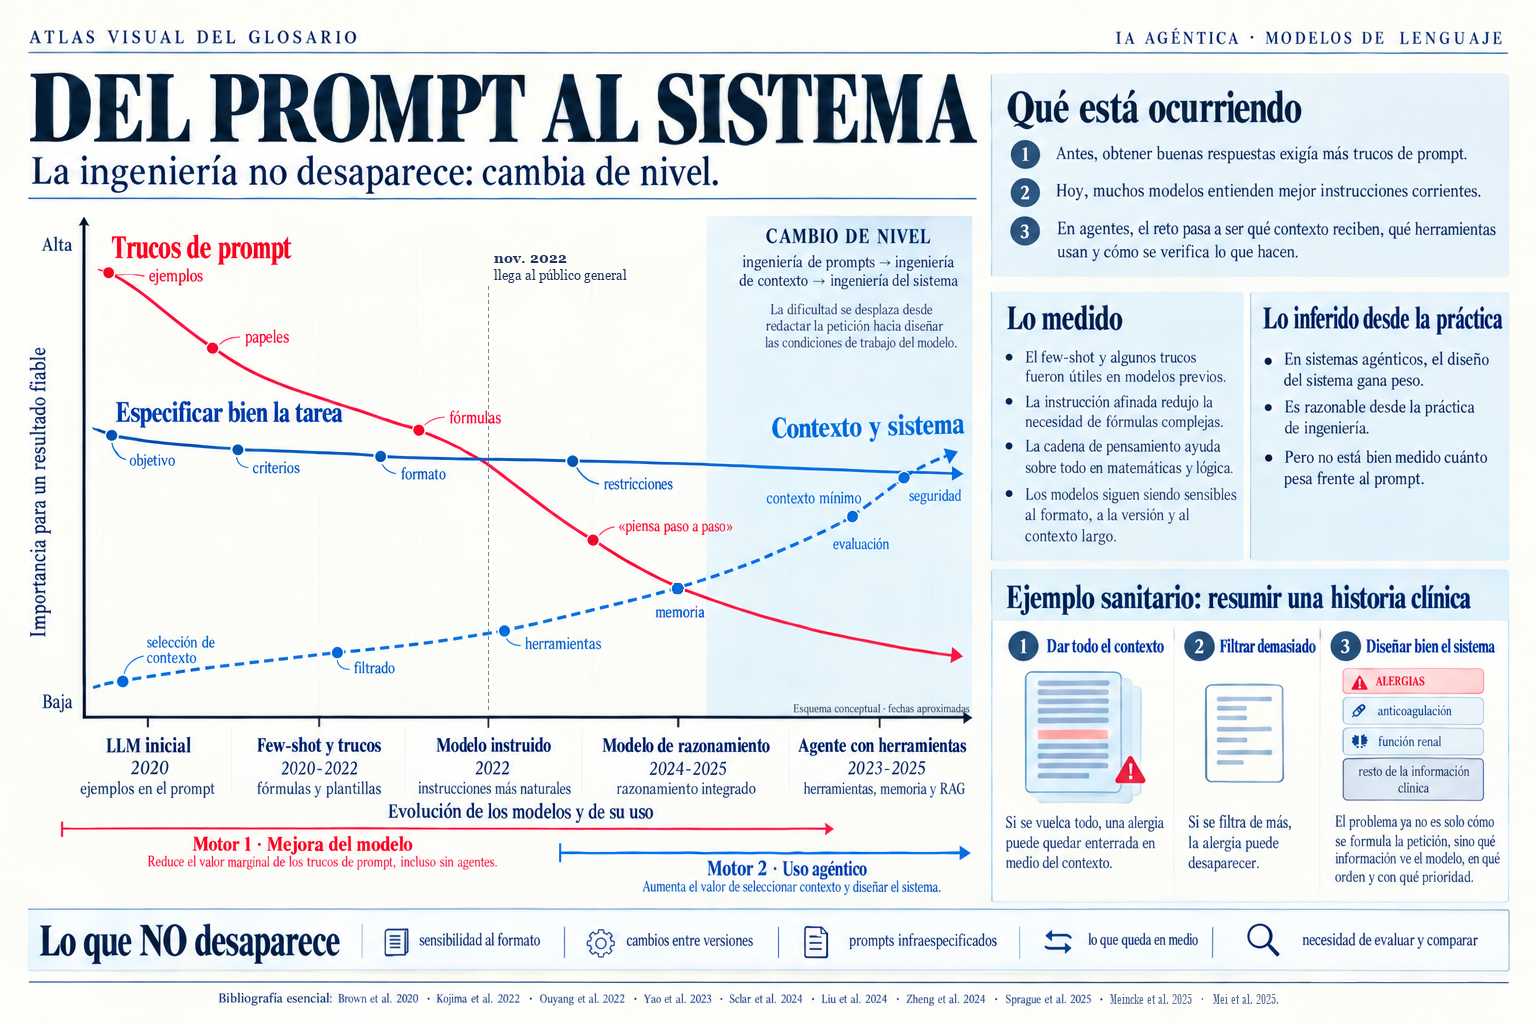
Cómo leerla
La lámina sigue dos motores que suelen confundirse. El primero es la mejora de los propios modelos entre 2020 y 2025: explica que los trucos de redacción rindan menos, y actúa también en una conversación normal, sin herramientas. El segundo es el uso de los modelos como agentes, que encadenan pasos y herramientas: no hace menos necesario el prompt, sino que añade un trabajo nuevo, decidir qué información recibe el modelo en cada paso y cómo se diseña el sistema que lo rodea.
El eje horizontal sigue la historia técnica, con fechas aproximadas que se solapan: los modelos de razonamiento y los agentes se generalizaron casi a la vez. La línea vertical de noviembre de 2022 marca la llegada al público general: ChatGPT se presentó entonces como un modelo ajustado a instrucciones con retroalimentación humana, el mismo método del modelo instruido [1]. Las dos primeras etapas fueron, por tanto, cosa de desarrolladores e investigadores. Los trucos se inventaron antes de que el público llegara, y muchos usuarios los conocieron cuando, según los estudios de las secciones siguientes, ya empezaban a perder valor.
Las tres curvas no son datos. La roja y la azul continua resumen lo que han medido los estudios citados abajo; la azul punteada es una inferencia desde la práctica de ingeniería, y por eso se dibuja distinta.
Primer motor: el modelo mejora
2020. Aprender con ejemplos. El artículo de GPT-3 mostró que un modelo suficientemente grande podía resolver tareas nuevas a partir de unos pocos ejemplos incluidos en el prompt, sin reentrenarlo [2]. Es el origen del few-shot learning como técnica de prompting, y de la idea de que la redacción del prompt era la palanca principal.
2022. «Piensa paso a paso». Añadir esa frase subió la precisión de un modelo de 2022 en un conjunto de problemas aritméticos del 17,7 % al 78,7 % [3]. Pedir ejemplos de razonamiento intermedio tuvo un efecto parecido [4]. Es la época en que encontrar la fórmula exacta cambiaba mucho el resultado.
2022. Ajuste a instrucciones. Entrenar el modelo con retroalimentación humana para seguir instrucciones cambió la relación: las respuestas de un modelo ajustado de 1.300 millones de parámetros se prefirieron a las del modelo original de 175.000 millones, cien veces mayor [5]. Desde entonces, una instrucción en lenguaje natural funciona sin necesidad de ejemplos ni plantillas.
2024. Los papeles no ayudan. Un estudio con 162 papeles distintos («eres un médico», «eres un abogado»), 2.410 preguntas y cuatro familias de modelos no encontró que asignar un papel en el prompt de sistema mejorara las respuestas frente a no asignar ninguno [6]. Otros recursos habituales, como la cortesía o las restricciones de formato, tienen efectos que unas veces ayudan y otras perjudican según la pregunta [7].
2024-2025. Modelos que ya razonan. Cuando el modelo razona antes de responder, pedirle la cadena de pensamiento aporta poco o nada a la precisión y aumenta el coste y el tiempo [8]. Un análisis de más de cien estudios encontró que la cadena de pensamiento ayuda sobre todo en matemáticas y lógica, con ganancias mucho menores en el resto de tareas [9]. En un modelo de razonamiento, sus autores observaron que incluir ejemplos en el prompt empeoraba el resultado de forma sistemática y recomendaron describir el problema directamente [10].
Lectura. La técnica que en 2020 era imprescindible, los ejemplos, puede ser contraproducente en 2025, y la frase que en 2022 multiplicaba la precisión apenas aporta con los modelos que ya razonan. Nada de esto requiere agentes: es el modelo el que ha cambiado.
Lo que no desaparece: la sensibilidad al prompt
La mejora no ha eliminado el efecto de la forma de pedir. Cambios de formato sin relación con el contenido, como la puntuación o los separadores, movieron la precisión hasta 76 puntos en un modelo abierto de 2023, y la sensibilidad se mantuvo al aumentar el tamaño, añadir ejemplos o ajustar a instrucciones [11]. Un estudio de 6,5 millones de casos con 20 modelos y 39 tareas concluyó que evaluar un modelo con un solo prompt da resultados frágiles y recomendó usar varios [12]. Otro encontró que los modelos más grandes son más robustos a estas variaciones, pero no inmunes [13].
A esto se suma que el mismo modelo cambia de una versión a otra: entre marzo y junio de 2023, una versión comercial varió su precisión en tareas concretas y su respuesta a la petición de razonar paso a paso [14]. Un prompt ajustado a una versión puede dejar de funcionar en la siguiente.
Lectura. La sensibilidad disminuye con los modelos más capaces, pero no llega a cero. Cuánto ha bajado con los modelos de 2025 no está bien medido: los estudios más citados usan modelos de 2023 y 2024.
La especificación sigue haciendo falta
Un modelo que entiende mejor no puede usar lo que no se le dice. Un estudio de 2025 encontró que los modelos infieren por su cuenta algo menos de la mitad de los requisitos no especificados (41,1 %), y que los prompts infraespecificados tenían el doble de probabilidad de fallar al cambiar de modelo o de redacción. Pero también que especificar todos los requisitos no mejora el resultado de forma consistente, porque el modelo no sigue bien todas las instrucciones y algunas entran en conflicto [15].
Ese resultado respalda a la vez las dos maneras de fallar de la lámina: especificación insuficiente, cuando el modelo tiene que inventar lo que nadie le dio, y exceso de instrucciones, cuando se le acumulan requisitos que no puede atender a la vez.
Más información tampoco es siempre mejor. Con textos largos, los modelos aprovechan peor lo que queda en medio que lo que está al principio o al final [16].
Segundo motor: el uso agéntico
Desde 2023, patrones como ReAct permiten que un modelo alterne razonamiento y acciones con herramientas [17]. En un sistema multiagente o un agente que trabaja muchos pasos, la información que ve el modelo cambia en cada paso y hay que gestionarla: qué se recupera, qué se resume, qué se guarda en memoria. Es la ingeniería de contexto, que Anthropic presenta como la progresión natural de la ingeniería de prompts [18] y que una revisión de 2025 propone tratar como disciplina propia [19]. Alrededor, el andamiaje del agente decide qué herramientas hay, qué límites se imponen y qué queda registrado.
Qué está medido y qué es inferencia
| Afirmación | Base |
|---|---|
| Los trucos de redacción rinden menos con modelos más capaces | Estudios experimentales, varios y concordantes |
| La sensibilidad al prompt disminuye pero persiste | Estudios experimentales, con resultados en parte discrepantes y modelos de 2023-2024 |
| La infraespecificación hace frágil el resultado | Un estudio experimental, preprint |
| En textos largos, lo que queda en medio se aprovecha peor | Estudio experimental publicado |
| Con agentes, el diseño del sistema gana peso | Documentación de ingeniería y una revisión; no medido |
La última fila es la inferencia más razonable a partir de la práctica, pero ningún estudio ha medido cuánto pesa el diseño del sistema frente a la redacción del prompt. Por eso la lámina la representa de forma distinta.
La amplitud del campo también es un dato: una revisión sistemática de 2024 catalogó 58 técnicas de prompting para texto [20]. Que muchas de ellas aporten poco con los modelos actuales no las hace inútiles en todos los casos, pero sí desaconseja tomarlas como recetas universales.
El ejemplo sanitario
Un sistema resume una historia clínica con varias fuentes. Si recibe todo, la alergia puede quedar enterrada en medio de un texto largo; si se filtra de más, no llega al modelo. La tercera opción no es encontrar el punto medio de cantidad, sino diseñar el orden y la prioridad: alergias, anticoagulación y función renal, por delante del resto. Ninguna redacción del prompt compensa un contexto mal diseñado: el riesgo se decide antes, al elegir qué información recibe el modelo, en qué orden y con qué prioridad.
Alcance
Es un esquema conceptual: las fechas son aproximadas, las curvas no son datos y los ejemplos sanitarios son hipotéticos. Los estudios citados usan modelos, tareas y pruebas concretas, casi todas no clínicas, y sus cifras no deben trasladarse a otros sistemas. Varios son preprints o informes técnicos, y así consta en la bibliografía.
Un buen diseño del sistema no garantiza respuestas correctas ni sustituye la revisión humana. La persona pasa de redactar a supervisar, con el riesgo de sesgo de automatización y de fatiga que eso implica.