Del benchmark a la cabecera
Un modelo puede resolver muy bien una tarea clínica controlada. Entre esa competencia y un beneficio sostenido para los pacientes hay una cadena de saltos, y en cada uno cambia la pregunta que hay que responder. La lámina recorre esa cadena de izquierda a derecha, sitúa las cuatro puertas que la atraviesan y dice, para cada una, qué se gana, qué puede fallar y qué tipo de estudio es capaz de contestarla.
Cómo leerla
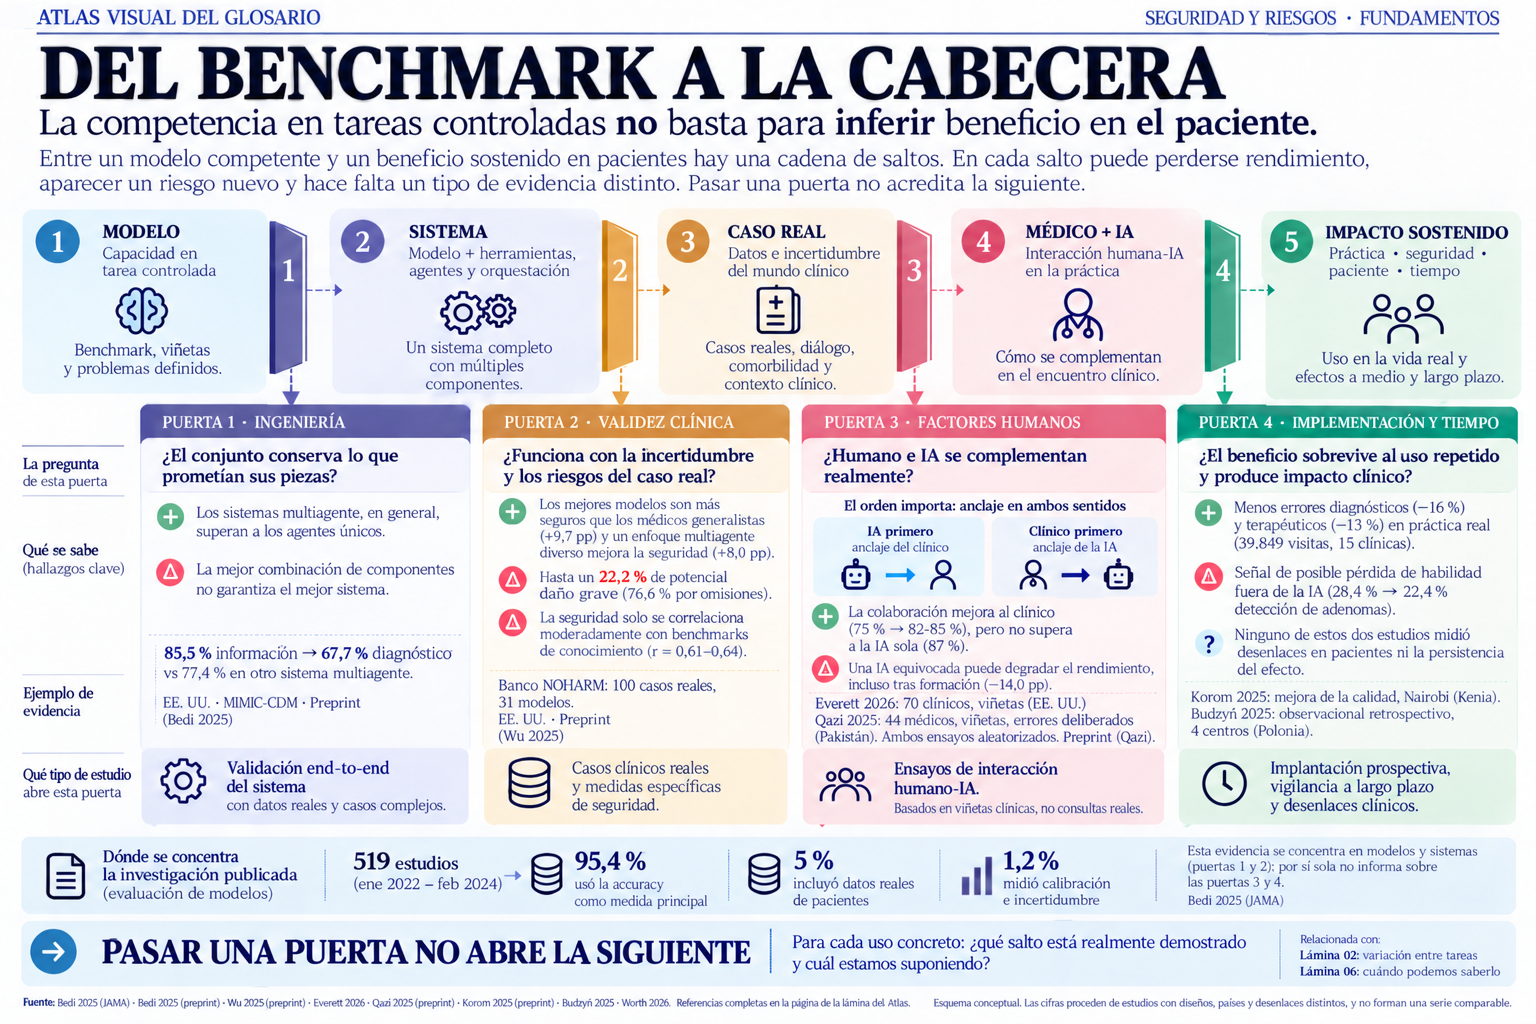
La lámina se lee de izquierda a derecha. El eje horizontal no es el tiempo ni la madurez: es la distancia que separa lo que se ha demostrado de lo que le ocurre al paciente. En el extremo izquierdo sabemos algo acotado, que el modelo resuelve una tarea; en el derecho queremos saber algo mucho más exigente, que su uso produce un beneficio sostenido sin introducir daños nuevos.
Entre ambos extremos hay cuatro puertas, y la idea central es que cada una formula una pregunta distinta: la primera es de ingeniería, la segunda de validez clínica, la tercera de factores humanos y la cuarta de implantación y tiempo. Por eso atravesar una no acredita la siguiente: un estudio que responde a una no dice nada de las demás.
Las barreras entre estaciones no significan que se pierda rendimiento necesariamente. Significan que ahí cambia el objeto de estudio.
En cada puerta, el signo + marca lo que la evidencia permite ganar y el triángulo lo que puede fallar. Las dos cosas aparecen siempre juntas, porque casi todas estas fuentes documentan a la vez un beneficio y un límite. El interrogante de la cuarta puerta señala lo que todavía no está establecido.
Las cuatro puertas
Esta sección repite en texto el contenido de la lámina, con sus fuentes. Puede leerse sin necesidad de ampliar la imagen.
Puerta 1 · Ingeniería
¿El conjunto conserva lo que prometían sus piezas?
Un sistema multiagente ensamblado con los mejores componentes alcanzó un 85,5 % de exactitud en la información, una métrica de proceso, pero solo un 67,7 % de precisión diagnóstica, por debajo del 77,4 % de otra arquitectura multiagente, sobre 2.400 casos reales de pacientes en cuatro patologías abdominales [1]. En el mismo estudio, los sistemas multiagente superaron en general a los agentes únicos.
El hallazgo no es que añadir agentes empeore: es que la mejor combinación de piezas no da el mejor sistema, y que por tanto un sistema se valida entero o no se valida. Es la puerta que continúa lo que explica la lámina «Del prompt al sistema», y donde entra en juego el sistema multiagente.
Puerta 2 · Validez clínica
¿Funciona con la incertidumbre y los riesgos del caso real?
Sobre 100 casos reales de derivación de atención primaria a especialista y 31 modelos evaluados, el banco de pruebas NOHARM encontró potencial de daño grave en hasta un 22,2 % de los casos, con las omisiones como el 76,6 % de los errores. En el mismo trabajo, los mejores modelos superaron en seguridad a los médicos generalistas (+9,7 puntos) y un enfoque multiagente diverso mejoró la seguridad frente a los modelos en solitario (+8,0 puntos) [2].
El dato que de verdad sostiene esta puerta no es el 22 %, sino que la seguridad clínica solo se correlaciona moderadamente (r = 0,61-0,64) con los bancos de pruebas de IA y de conocimiento médico existentes. Es decir: la seguridad es una dimensión distinta del conocimiento médico, y un benchmark de conocimiento no la predice. Hay que medirla aparte.
Puerta 3 · Factores humanos
¿Humano e IA se complementan realmente?
En un ensayo aleatorizado con 70 clínicos, los que usaron recursos convencionales acertaron un 75 %; con la IA como segunda opinión, un 82 % (+6,8 puntos; IC 95 % 4,0 a 9,6); con la IA como primera opinión, un 85 % (+9,9 puntos; IC 4,7 a 15,0). La IA sola alcanzó un 87 %, sin diferencia estadística frente a la colaboración (p = 0,20) [3].
La lectura correcta tiene dos mitades. La colaboración mejora claramente al clínico, y esa ganancia es grande y significativa. Lo que no hay es ganancia de la pareja sobre la máquina sola: la complementariedad completa, aquella en que cada uno corrige los errores del otro, sigue siendo rara.
Los autores proponen un mecanismo, y es lo más útil de toda la lámina: el anclaje opera en los dos sentidos. Si la IA responde primero, el clínico se ancla en ella, porque sus inferencias resultan más persuasivas antes de que uno forme su propio juicio. Si el clínico responde primero, es la IA la que se ancla en él y pierde capacidad de aportar algo distinto. Quien va segundo hereda el marco del primero.
La segunda mitad de esta puerta es el daño. En un ensayo aleatorizado con 44 médicos de Pakistán, todos ellos formados en un curso de alfabetización en IA de 20 horas, el grupo que recibió recomendaciones de un modelo sin errores acertó un 84,9 % y el que las recibió con errores deliberados en la mitad de los casos, un 73,3 %: −14,0 puntos (IC 95 % −18,9 a −9,1) [4]. Es sesgo de automatización, y conviene leerlo con tres precisiones:
- El grupo de control no era «sin IA». Los dos grupos tenían IA; uno la tenía correcta y el otro con errores. La cifra mide el daño de una IA equivocada frente a una IA acertada, no el de usar IA frente a no usarla.
- La experiencia no protegió: empeoró el efecto. Los médicos con diez años o más de ejercicio (la mediana de la muestra) cayeron 16,6 puntos; los de menos, 9,1. Los autores lo discuten como hallazgo central, porque contradice el supuesto de que el veterano detecta el error.
- Los errores eran deliberados, introducidos por un panel de médicos para ser detectables pero no evidentes. Los errores reales de un modelo pueden ser más sutiles.
Puerta 4 · Implementación y tiempo
¿El beneficio sobrevive al uso repetido y produce impacto clínico?
En 15 clínicas de atención primaria de Nairobi, sobre 39.849 visitas, el uso de un asistente integrado en la historia clínica se asoció a un 16 % menos de errores diagnósticos y un 13 % menos de errores terapéuticos, en términos relativos y valorados por médicos independientes [5]. Es un estudio de mejora de la calidad, no un ensayo.
La otra cara de esta puerta es el tiempo. En cuatro centros de endoscopia de Polonia, la tasa de detección de adenomas en las colonoscopias hechas sin asistencia bajó del 28,4 % antes de introducir la IA al 22,4 % después [6]: una señal de posible pérdida de habilidad cuando la ayuda no está. Es un estudio observacional y el verbo de los autores es «podría».
Ninguno de los dos estudios midió desenlaces de salud en los pacientes ni la persistencia del efecto: eso es lo que la lámina marca con el interrogante. La abren la implantación prospectiva, la vigilancia a largo plazo y los desenlaces clínicos.
El interrogante ya tiene una primera respuesta en el mismo entorno. Un ensayo pragmático aleatorizado por conglomerados en 16 centros de atención primaria de Kenia, con una herramienta casi idéntica a la del estudio anterior, asignó 103 clínicos a trabajar con o sin la asistencia del modelo y siguió a 9.691 pacientes. La asistencia fue segura y mejoró la calidad de la documentación, pero no redujo de forma significativa el fracaso terapéutico a los 14 días (OR ajustada 0,77; IC 95 % 0,55 a 1,08; p = 0,13) [7]. Es la tesis de la lámina con datos: mejorar el proceso no garantiza el resultado en el paciente. La imagen todavía no recoge este ensayo.
Dónde se concentra la investigación publicada
De 519 estudios de evaluación de modelos de lenguaje en sanidad publicados entre enero de 2022 y febrero de 2024, el 95,4 % usó la exactitud como dimensión principal, solo el 5 % incorporó datos reales de atención a pacientes y únicamente el 1,2 % midió calibración e incertidumbre [8].
Esa fotografía describe sobre todo las puertas 1 y 2, que es donde se concentra la literatura de evaluación. No es un reparto por puertas y por sí sola no informa de lo que ocurre en las puertas 3 y 4; lo que sí dice es que las preguntas que esas dos puertas plantean se han investigado mucho menos.
Alcance
Es un esquema conceptual. Las cinco posiciones y las cuatro puertas son una construcción propia sobre las fuentes citadas, no una clasificación establecida, y en la práctica los saltos se solapan. La anchura de cada columna no representa ninguna magnitud.
Las cifras no forman una serie comparable. Proceden de diseños, poblaciones, países y desenlaces distintos: datos retrospectivos de Estados Unidos, un ensayo con clínicos estadounidenses, otro con médicos de Pakistán, una implantación en Kenia y un estudio observacional en Polonia. Ponerlas en una misma lámina sirve para ver que cada puerta se contesta con un tipo de estudio, no para restarlas entre sí.
Cuatro de las siete fuentes de la imagen son preprints, sin revisión por pares: las dos primeras puertas y el estudio de Kenia, más el ensayo de sesgo de automatización, cuya versión revisada existe pero no es accesible. Están marcadas como tales en la lámina. El riesgo de un preprint no es la invención, sino que una cifra cambie al publicarse; las entradas bibliográficas llevan versión y fecha de consulta para que ese cambio sea detectable.
La evidencia de pérdida de habilidad procede de un dominio, la colonoscopia, con un diseño observacional retrospectivo en cuatro centros de un país [6]. No establece una pérdida de habilidades del clínico en general; el verbo de los autores es «podría». Y el estudio de implantación en Kenia es un estudio de mejora de la calidad, no un ensayo, cuyo resultado los propios autores atribuyen en parte a una implantación muy alineada con el flujo de trabajo [5].
Ninguno de los dos estudios de la cuarta puerta que recoge la imagen midió desenlaces de salud en los pacientes ni la persistencia del efecto en el tiempo: uno valoró errores clínicos juzgados por médicos y otro una medida de calidad de la exploración. El ensayo de 2026 citado en la actualización de la cuarta puerta sí midió un desenlace en pacientes, a 14 días; la persistencia del efecto sigue sin estudiarse.
El conjunto de fuentes procede en buena parte de una revisión narrativa de 82 estudios cuyos autores reconocen sesgo de selección hacia instituciones académicas bien conectadas [9]. Las cifras de esta lámina se han contrastado una a una contra su estudio original, no contra esa revisión.
Esta lámina responde a «qué falta por demostrar». La lámina «El problema del ritmo» responde a una pregunta distinta y complementaria, «cuándo podremos saberlo». Y la lámina «La frontera tecnológica es dentada» trata la variación entre tareas parecidas, no la profundidad de la traslación: ahí el concepto es la frontera tecnológica dentada.